

Inżynieria + DevOps + AI
= AI-native SDLC.
Przez tydzień operowałem fabryką software. Agenci prowadzą pełny cykl ticketu: plan, build, verify, code review. Deterministyczny harness pilnuje kontraktów, budżetów i bramek. Człowiek podejmuje dwie decyzje na ticket: aprobatę planu i merge. To model, który Gartner nazywa dark factory. Tutaj zbudowany i sprawdzony w praktyce: architektura, realne koszty i to, co się psuło.
Zbudowałem działającą fabrykę software: agenci planują, budują, testują i robią code review, a człowiek podejmuje dokładnie dwie decyzje — akceptuje plan i merguje PR. Przez tydzień przepuściłem przez nią 50 ticketów. To jest zapis tego eksperymentu: architektura, liczby i to, co się psuło. Mogę się mylić w wielu miejscach. Wnioski opieram na danych z runów.
Vibecoding i harnessy CLI są świetne. Sześć problemów zostaje.
Claude Code, Codex i podobne harnessy CLI to realny skok produktywności; kod naprawdę powstaje szybciej. „Agent + prompt” działa świetnie do pierwszego poważnego incydentu. Poniżej sześć problemów, które znam z praktyki, i mechanizm, którym fabryka odpowiada na każdy z nich.
Brak synergii między modelami
Jeden model planuje, pisze i sam ocenia własną pracę. Mocne strony pozostałych leżą odłogiem, a sędzia jest stroną.
Niedeterministyczna kontrola
O tym, czy zmiana jest OK, decyduje… AI, na podstawie wrażenia. Werdykt potrafi być inny przy każdym uruchomieniu.
Nieprzewidywalne koszty, brak twardych bramek
Sesja potrafi zjeść dowolny budżet, a żadna bramka jakości nie zatrzyma pracy, która idzie w złą stronę.
Slop code wchodzi do repo
Bo nikt nie ma czasu (ani chęci) czytać i odrzucać wygenerowanych PR-ów. Jakość jedzie na zaufaniu.
Trudne podpinanie zewnętrznych źródeł
Kolejka zadań, rejestry projektów, CI, tracking — da się to spiąć z sesją agenta, ale na każdym szwie ręcznie.
Brak miejsca na lokalne modele
Compliance i koszty mówią „lokalnie”, ale typowa sesja agenta jest przyspawana do jednego chmurowego CLI.
Narzędzia AI są wszędzie. Efektu biznesowego nie widać.
Znam to z obu stron. Deweloperzy raportują, że z copilotem piszą szybciej i tak to czują. Liderzy patrzący na speed-to-market nie widzą różnicy. Gartner zmierzył tę rozbieżność i wyszła z tego jedna z mocniejszych liczb, jakie widziałem w badaniach nad produktywnością:
Copilot przyspiesza fragmenty pracy. Proces i struktura zostają stare. Kolejka, handoffy, review, release: wszystko czeka na człowieka dokładnie tam, gdzie czekało wcześniej. Krótszy jest tylko czas pisania kodu. Czas czekania zostaje taki sam.
Kluczowe rozróżnienie, na którym stoi cały ten tekst, wygląda tak:
Każdy krok nadal należy do człowieka. AI skraca same kroki. Czekanie między nimi zostaje, dlatego lider nie widzi efektu.
Człowiek decyduje na wejściu i na wyjściu. Pomiędzy pracują agenci i deterministyczny harness. Zmienia się struktura procesu, więc zmianę widać w wynikach biznesowych.
Autonomiczna jednostka wykonawcza SDLC: agenci planują, budują, testują i pakują pracę pod kontrolą harnessu. Na wejściu stoi intake gate — agent sprawdza, czy zgłoszenie nadaje się do produkcji, i odsyła niejasne wejścia do człowieka. Na wyjściu inspection gate — człowiek ogląda wynik razem ze śladem dowodowym. Na halę produkcyjną pomiędzy nimi nikt nie wchodzi. Gartner widzi cztery typy takich fabryk: research, plan, implement i verify.
C.A. Swan, „Dark Factories, Run by AI Agents, Will Power the Zero-Friction SDLC”, Gartner, 26.05.2026 (G00855838). Dark factory to jednostka operacyjna docelowego stanu, który Gartner nazywa zero-friction SDLC.Wspólna warstwa sterująca wokół agentów. Podaje im właściwy kontekst, ogranicza dostęp do narzędzi, zapisuje każdą akcję i sprawdza wyniki względem standardów organizacji. U Gartnera buduje go i zarządza nim centralny zespół platformowy, żeby każda fabryka jechała na tych samych kontrolkach. U mnie to deterministyczny kod: kontrakty werdyktów, bramki, budżety, routing i artefakty. To słowo wraca w całym tekście.
Moje pytanie badawcze było proste:
Ile z tego modelu da się zbudować dziś, na subskrypcjach konsumenckich CLI — i gdzie są prawdziwe granice?
Jak praca przepływa przez fabrykę.
Kolejką i pulpitem sterowniczym jest Linear. Ticket wjeżdża do fabryki, agent planuje, człowiek akceptuje plan przeciągnięciem karty — i od tego momentu, aż do gotowego PR, nikt nie siedzi przy klawiaturze.

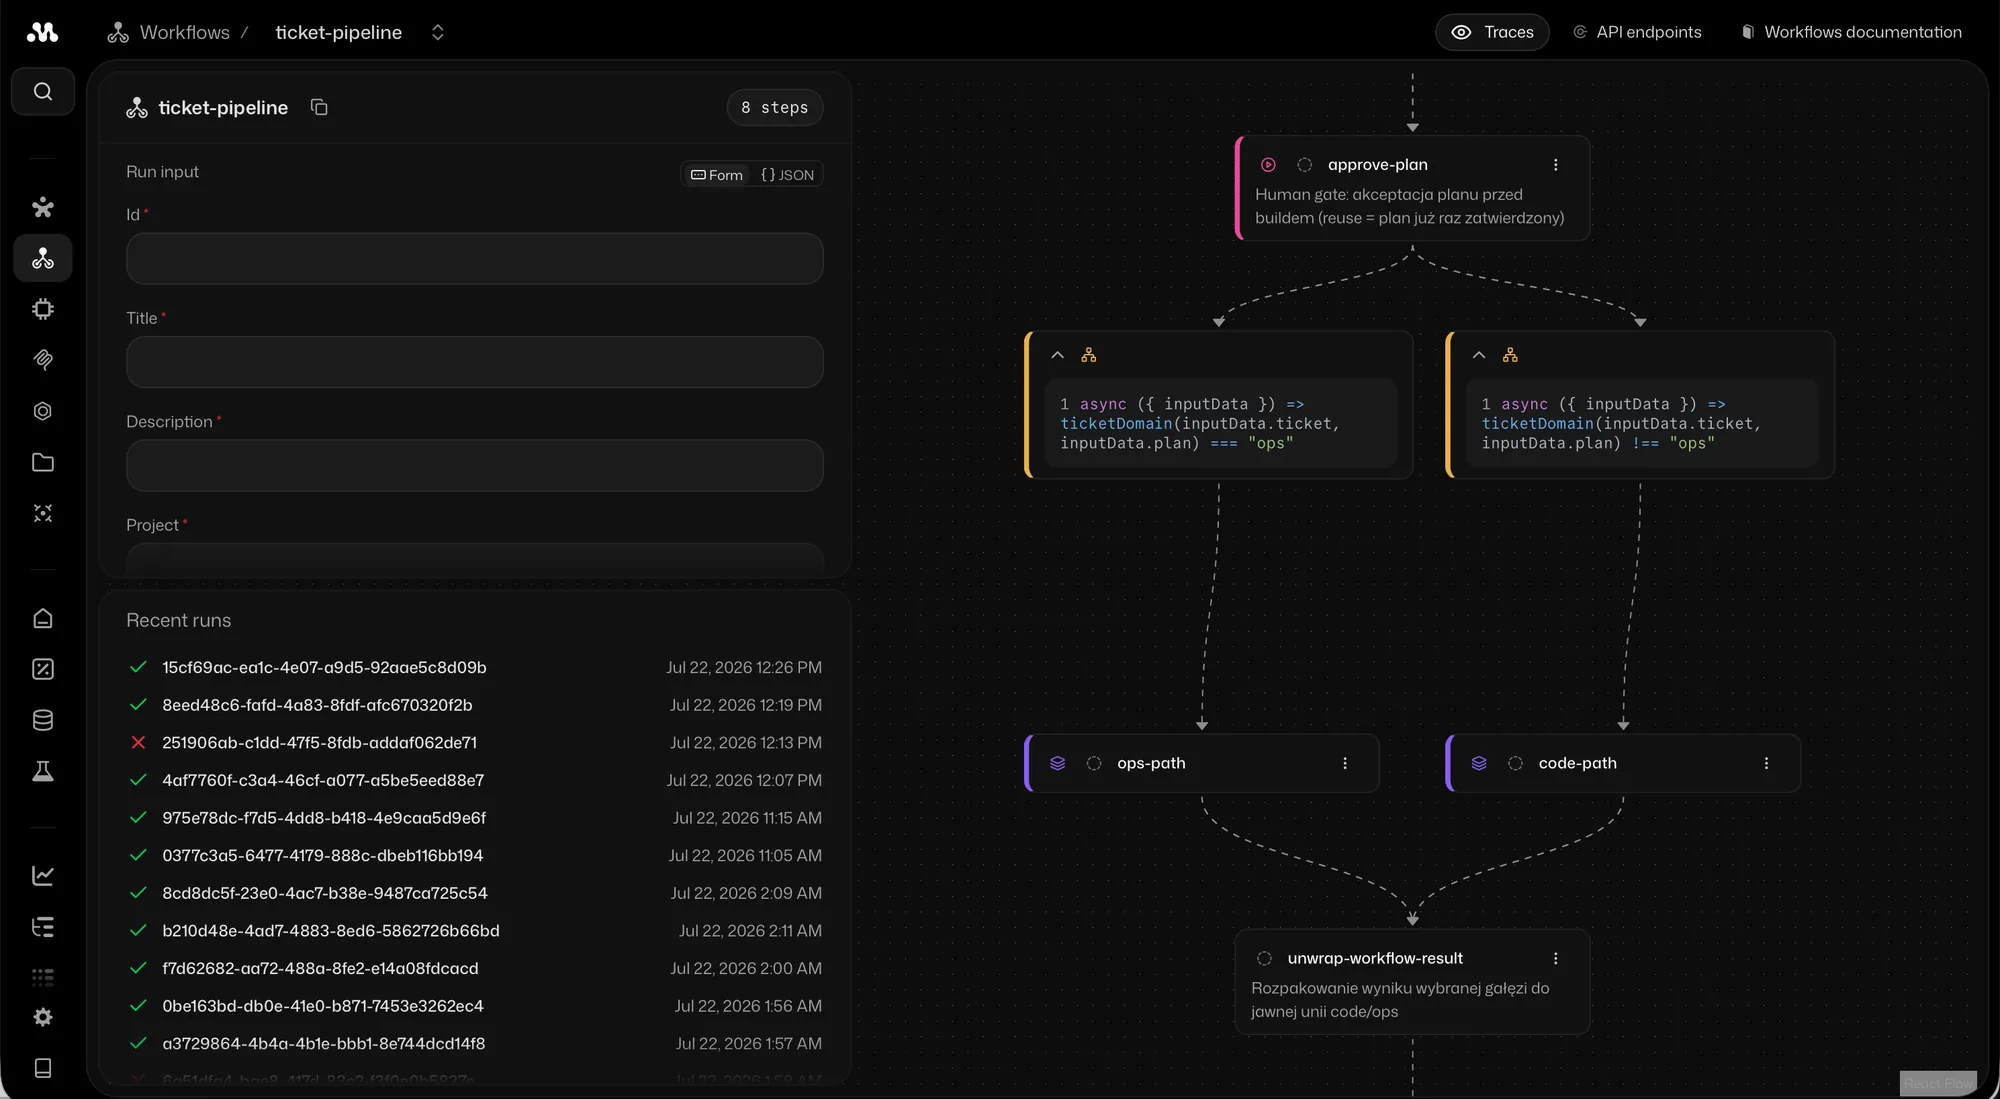
Ten graf działa naprawdę — na frameworku Mastra.
Fabryka stoi na Mastra — otwartym frameworku TypeScript do agentów i workflow. Rozwiązań tej klasy jest więcej; Mastra po prostu podpasowała: workflow jako graf z deterministycznymi krokami, human gate wpinany bezpośrednio w graf i panel runów, który widać na zrzutach.
Intake to deterministyczny kod, a approve-plan to bramka ludzka wpięta w graf, więc agent nie może jej ominąć; plan bez jednoznacznego werdyktu kończy jako twardy BLOCKED.
Zrzut z implementacji · Mastra
Fundament autonomii: głęboki brak zaufania do agentów.
Deterministyczny kod robi git, CI, routing i budżety. Agenci wyłącznie myślą.
Commituje fabryka. Agent nigdy nie dotyka gita, nie odpala CI, nie zarządza gałęziami. Wszystko, co da się zrobić kodem, robi kod, bo kod działa przewidywalnie.
Fail-closed wszędzie.
Werdykt agenta to ścisły kontrakt strukturalny (blok JSON). Brak werdyktu albo niejednoznaczność = STOP bez zgadywania. Review bez jednoznacznego LGTM znaczy: są uwagi.
Dwie bramki ludzkie, zero auto-merge.
Sterowanie odbywa się przez stany kanbana. Aprobata planu i merge — obie decyzje da się podjąć z telefonu: przeciągnięcie karty, /approve, /reject.
Izolacja i zakres.
Worktree per ticket. Zmiany buildera muszą być podzbiorem plików zadeklarowanych w zatwierdzonym planie. Rezerwacja plików między ticketami, merge queue i re-verify przy każdym ruchu maina.
Multi-engine z routingiem ról.
Plan, verify, review i build mogą jechać różnymi modelami — routing per rola, domena i projekt. Tańsze modele tam, gdzie wystarczą; zero uzależnienia od jednego vendora.
Ekonomia wbudowana od pierwszego dnia.
Budżet per ticket, circuit breaker $/h, plan-reuse („nie generujemy planu bez powodu”) i pełne metryki per wywołanie: koszt, czas, first-pass — per etap i model.
Ostatni wiersz jest ważniejszy niż pozostałe. U Gartnera intake gate obsługuje agent, a jedyna ludzka bramka stoi na wyjściu. Ja trzymam dodatkową bramkę na wejściu, bo przy jednoosobowym zespole i modelach z 2026 roku wolę zapłacić minutą uwagi za plan niż godziną za sprzątanie. To świadome cofnięcie się o krok od modelu docelowego.
Model, który napisał kod, nigdy nie ocenia własnej pracy.
Każda rola w fabryce może jechać innym modelem — i to jest bezpośrednie źródło jakości. Planner myśli szeroko, builder pisze, verifier i reviewer patrzą na wynik świeżymi, cudzymi oczami — ta sama zasada, dla której autor oddaje kod do review koledze. Druga decyzja: każdy silnik to natywny harness CLI vendora (Claude Code od Anthropic, Codex od OpenAI). Agentic loop, narzędzia i praca z repo to lata inżynierii strojonej pod konkretny model, których nie zamierzam odtwarzać sam. Mój harness orkiestruje harnessy: kontrakty, bramki i budżety nad nimi, cała inżynieria agentowa vendora pod spodem.
Przy niejasnym tickecie fabryka pyta autora.
Najtańszy moment na złapanie błędu to moment przed napisaniem pierwszej linijki. Kiedy planner uznaje ticket za niejednoznaczny, zadaje autorowi numerowane pytania z opcjami i rekomendacją. Odpowiedź wraca do tego samego runu. To intake gate w praktyce.
Pytanie 1/1 · Ticket mówi „dodaj eksport danych”. Nie precyzuje formatu ani zakresu:
Pulpit sterowniczy to zwykły kanban.
Stany tablicy w Linear są jednocześnie stanami fabryki. Przeciągnięcie karty to komenda: z „Plan do akceptacji” do „Build” znaczy /approve. Całe sterowanie — łącznie z bramkami — mieści się w telefonie.
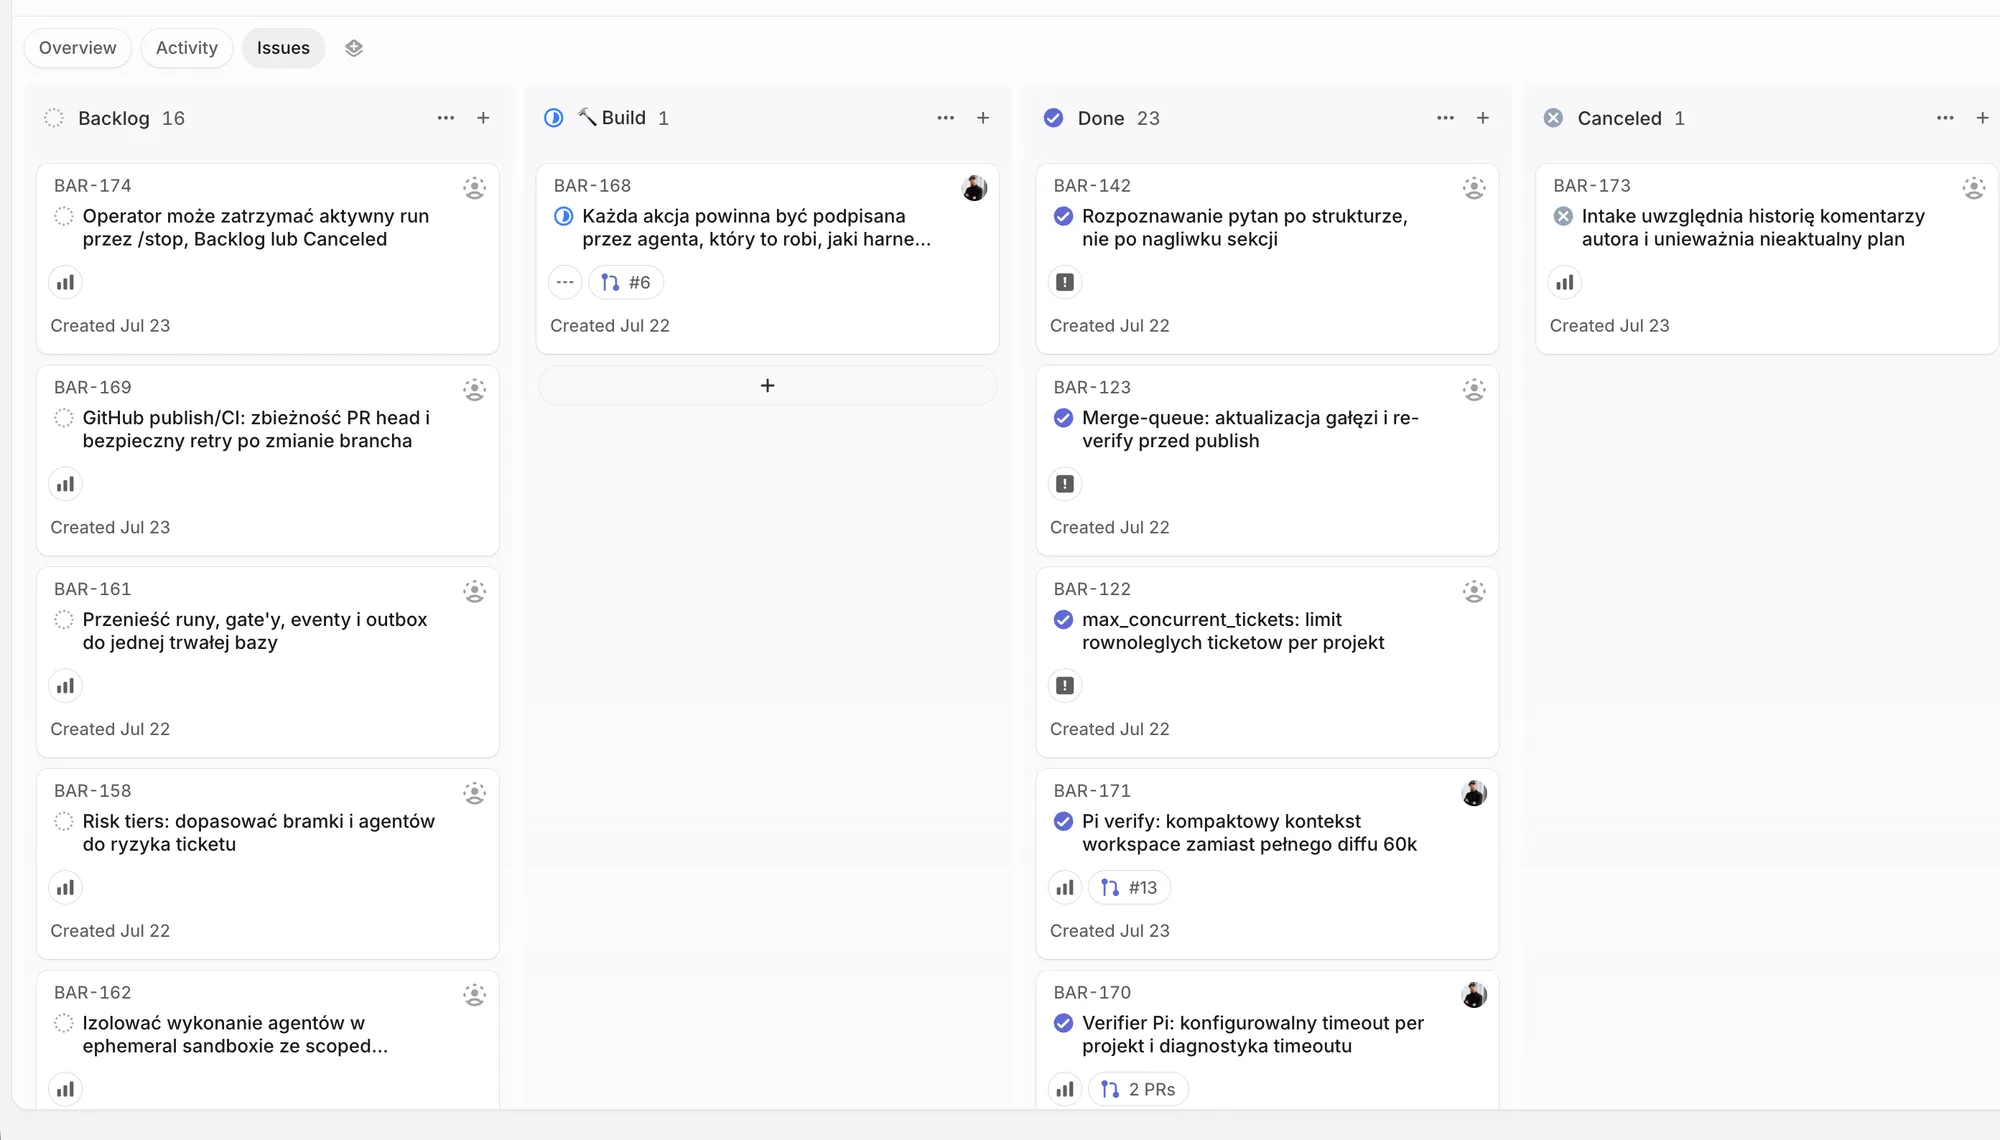
Padło na Linear. Równie dobrze sprawdzi się dowolne narzędzie, w którym zespół już zarządza ticketami. Kluczowa jest zasada: zero nowego frontendu dla biznesu. Fabryka wpina się tam, gdzie biznes już pracuje — i tam wystawia bramki, pytania plannera i statusy runów. Ticket, aprobata planu i merge żyją w tym samym miejscu, co cała reszta pracy zespołu.
Każdy run zostawia komplet artefaktów.
Plan, aprobata, log buildera, werdykt weryfikacji, rundy review, zrzuty ekranu i metryki — per ticket, per run. Kiedy coś pójdzie źle, otwieram folder runu i widzę, co agent zrobił.
Struktura rzeczywista · nazwy plików z repo
Co dowiozła fabryka — w liczbach.
Wszystkie kwoty w dolarach to ekwiwalent kosztu inferencji raportowany przez CLI na subskrypcjach konsumenckich, czyli miarę zużycia modeli. Podaję je, bo bez konkretu nie da się rozmawiać o ekonomii tego modelu.
- Ekwiwalent kosztu inferencji ($ ekw.)
- Ile te same wywołania kosztowałyby po cenniku API danego modelu. Fabryka jeździ na stałych subskrypcjach CLI, więc to miara zużycia — pozwala policzyć ekonomię przed przejściem na API i skalę.
- Wywołanie silnika
- Jedno uruchomienie agenta w jednej roli (plan, build, verify albo review) dla jednego ticketu. Ticket zużywa zwykle kilka wywołań, licząc rundy poprawek.
- Skuteczność wywołań (np. plan 94/95)
- Ile wywołań danej roli zakończyło się poprawnym, zgodnym z kontraktem wynikiem — bez błędu, timeoutu i restartu. Odpowiednik metryki „first-pass”.
- Koszt per ticket
- Suma ekwiwalentu kosztu wszystkich wywołań jednego ticketu — od planu po ostatnią rundę review, razem z poprawkami.
Tę sekcję czytaj najuważniej.
Nic z tego nie działało od razu. Poniżej realne awarie z tygodnia operacji — każda z konkretnym mechanizmem, który powstał w odpowiedzi.
Konflikt semantyczny przy 4+ równoległych ticketach
Dwa tickety zielone osobno, czerwone razem: zmiany w różnych plikach kolidowały w logice.
Oscylująca pętla review→fix
Reviewer żądał zmiany, fix ją wprowadzał, kolejna runda żądała odwrotnej. W kółko.
Zombie-runy i wiszące procesy
Run tracił silnik, proces wisiał godzinami, worktree zostawał zajęty.
Budżety czasu zabijały wolniejsze modele
Limit 5 minut na plan uśmiercał model klasy frontier w połowie myślenia.
Większość tej pracy to inżynieria niezawodności.
Prompty to mała część. Najwięcej pracy poszło w kontrakty, timeouty, kolejki, budżety i artefakty wokół agentów. Tę warstwę organizacja buduje u siebie i na niej opiera własny proces.
- Nie mówię „enterprise-ready”. To eksperyment jednoosobowy na dwóch repo: pilotażowe PWA (50 ticketów) i mój własny produkt (2 PR-y). Twierdzę tylko, że wzorce — bramki, kontrakty, fail-closed — są przenośne, a doświadczenie operacyjne realne.
- Koszty w $ to ekwiwalent API raportowany przez CLI na subskrypcjach konsumenckich, czyli miara zużycia modeli.
- Nie twierdzę „bez człowieka”. Człowiek stoi w dwóch dobrze zdefiniowanych miejscach i tak ma być.
Co bym z tego przeniósł do dużej organizacji.
Autonomiczni agenci na skalę enterprise: przepustowość w górę o 20–30%, lead time w dół o 15%, 70% podatności łatanych autonomicznie, pokrycie testami podwojone do 90%.
Mały, mieszany zespół plus harness sterowany specyfikacją: droga od koncepcji do działającego oprogramowania skróciła się z tygodni do dni.
Zacznij od jednego powtarzalnego strumienia pracy.
Fabryka to powtarzalna praca pod kontrolą harnessu. Jeden strumień daje mierzalne dane od pierwszego ticketu.
Harness to produkt centralny, budowany przez jeden zespół platformowy.
Kontrakty, budżety, routing i artefakty budowane raz i wspólne dla zespołów produktowych. Gartner stawia sprawę ostrzej: harness jest miejscem, w którym mieszka governance, więc kopiowanie go po zespołach kopiuje też ryzyko.
Zmienia się profil kompetencji: spec-and-inspect.
Pisanie precyzyjnych wejść i krytyczny audyt wyjść, w stylu przeglądu bezpieczeństwa. 51% CIO mówi, że rozwój wymaganych umiejętności wyprzedza to, co dowozi rynek pracy, więc ten profil trzeba wyhodować u siebie.
Miary od pierwszego dnia: koszt, czas, first-pass, per etap.
Te miary pokazują, czy adopcja daje przewagę, i dają enterprise dane do decyzji. Wdrożenie copilotów takich danych nie zbiera.
Jak taki model mógłby działać w Twojej organizacji?
Czekanie na decyzje, ręczne QA i review znikają ze środka procesu. Człowiek zostaje tam, gdzie jest niezbędny: przy decyzjach. Każdy run zostawia po sobie komplet artefaktów, więc kontrola nie kosztuje tempa.
Więcej rezultatu z tych samych modeli: frontier planuje, szybki koduje, inny recenzuje. Dwie głowy widzą więcej — a każda rola jedzie na stawce adekwatnej do zadania.
Routing ról dopuszcza modele self-hosted: niższe koszty inferencji i dane, które zostają w organizacji — naturalna ścieżka dla compliance.
Centralny system sterujący pozwala skodyfikować Wasz unikalny proces wytwarzania oprogramowania — i rozwijać go jak produkt, dopasowany do tego, jak pracuje Twój zespół.
Jeśli budżet na copiloty jest wydany, a efektu biznesowego nie widać — szukaj w procesie. Dokładnie ten problem przerabiałem przez ostatni tydzień na własnej skórze.
AI SDLC Readiness Sprint to 2–3 tygodnie wspólnej pracy: na wyjściu dostajesz ocenę gotowości, architekturę harnessu pod Wasz stack i plan pilota na jednym strumieniu pracy.
- Mapowanie SDLC i wybór strumienia pracy pod pilota — powtarzalnego i mierzalnego.
- Projekt harnessu i bramek pod Wasz stack: kontrakty, fail-closed, budżety, artefakty.
- Definicja metryk — koszt, czas, first-pass per etap, od pierwszego dnia.
- Plan pilota — lub pilotaż z Waszym zespołem jako etap 2.
Źródła: pojęcia „dark factory”, „intake/inspection gate”, „harness”, „spec-and-inspect” oraz przypadki Itaú Unibanco i Revvity pochodzą z noty C.A. Swana „Dark Factories, Run by AI Agents, Will Power the Zero-Friction SDLC” (Gartner, 26.05.2026, G00855838). Statystyki w Akcie I: 2026 Gartner Software Engineering Survey (n=482), Gartner Developer Experience Assessment Survey (n=6538) i 2025 Gartner AI in Software Engineering Survey (n=299), za notami G00844726 i G00843105. Wszystko parafrazuję zamiast cytować. Gartner nie rekomenduje ani nie firmuje tego eksperymentu, a badania te odzwierciedlają opinie respondentów, nie cały rynek. Architektura, kod, liczby z mojego pipeline’u i popełnione błędy są moje.